Inferenz-Benchmarks
Ephraim soll mehrere Klassen mit mindestens 90 aktiven Schülerinnen und Schülern unterstützen. Die direkten Messungen bestehen für verteilte kurze Anfragen. Der Frontendlauf liefert 117 erfolgreiche Chats und endet an einer Auftragsbegrenzung. Das vollständige 90er-Profil und das vorgeschlagene Wartezeitziel sind nicht bestanden. Hier stehen die erreichten Ergebnisse und ihre Grenzen.
1. Aktueller Messstand vom 7. Oktober 2026
Die direkte Messung für 90 virtuelle Nutzer mit verteilten kurzen Anfragen besteht vollständig. Neue Messungen mit 64 und 90 gemeinsamen Starts sowie begrenzte lange Kontexte und Thinking bestehen ebenfalls. Der frühere Versuch mit vier fehlenden Antworten bleibt als eigener negativer Befund erhalten. Der Frontendlauf endet mit 117 erfolgreichen Chats als negatives Kapazitätsergebnis. Das vollständige vereinbarte 90er-Profil ist nicht bestanden.
| Getrennte Messserie | Gestartet | Erfolgreich | Fehler | Nicht gestartet |
|---|---|---|---|---|
| Ursprünglicher Direktlauf vom 6.10. | 541 | 537 | 4 | 126 |
| Neue Messung mit 64 gemeinsamen Starts vom 7.10. | 64 | 64 | 0 | 0 |
| Ursprüngliche Reststufen vom 7.10. | 126 | 126 | 0 | 0 |
Die 126 Restanfragen umfassen 90 gemeinsame Starts, 22 Fälle mit längeren Eingaben und 14 Thinking-Anfragen. Der ursprüngliche Direktlauf enthält sechs Aufwärmanfragen. Die getrennten Serien werden nicht nachträglich zu einem fehlerfreien ursprünglichen Lauf zusammengelegt.
2. Das tatsächlich gemessene Unterrichtsprofil
Die Hauptmessung verwendet synthetische Aufgaben im Modus Instant. Das Modell war bereits geladen. Die Eingabe umfasste etwa 2.000 Tokens, also Texteinheiten. Die Aufgabe verlangte kurze Antworten aus zwei Sätzen. Das Ausgabelimit von 512 Tokens ist eine Obergrenze, keine gemessene Antwortlänge.
| Merkmal der verteilten Nutzung | Gemessener Umfang |
|---|---|
| Virtuelle Nutzer | 90 |
| Anfragen | 180, zwei pro Nutzer in fünf Minuten |
| Abstand der beiden geplanten Ankünfte | Genau 150 Sekunden je Nutzer |
| Eingabe je Anfrage | 2.039 vom Modellserver gemeldete Tokens |
| Ausgabelimit | 512 Tokens |
| Tatsächlich gemeldete Ausgabe | Durchschnittlich 63,02 Tokens, Minimum 59, Maximum 68 |
Die Ergebnisse gelten für dieses Profil. Sie belegen keine dauerhaft 512 Tokens langen Antworten und keinen kalten Modellstart. 90 aktive Personen lesen, schreiben und stellen Folgefragen. Sie sind von 90 gleichzeitig offenen Modellanfragen zu unterscheiden.
3. Verteilte Anfragen von 90 Nutzern
Alle 180 Anfragen endeten vollständig und ohne technische Fehler. Die Wartezeit beginnt an der geplanten Ankunft und enthält eine mögliche Aufnahmeverzögerung. Denktext gilt nicht als sichtbarer Antwortbeginn.
| Beobachtung | Minimum | Median | Maximum | p95 |
|---|---|---|---|---|
| Sichtbarer Antwortbeginn | 0,669 s | 1,1985 s | 2,360 s | 2,1968 s |
| Vollständige Antwort | 1,319 s | 2,559 s | 5,116 s | 4,4588 s |
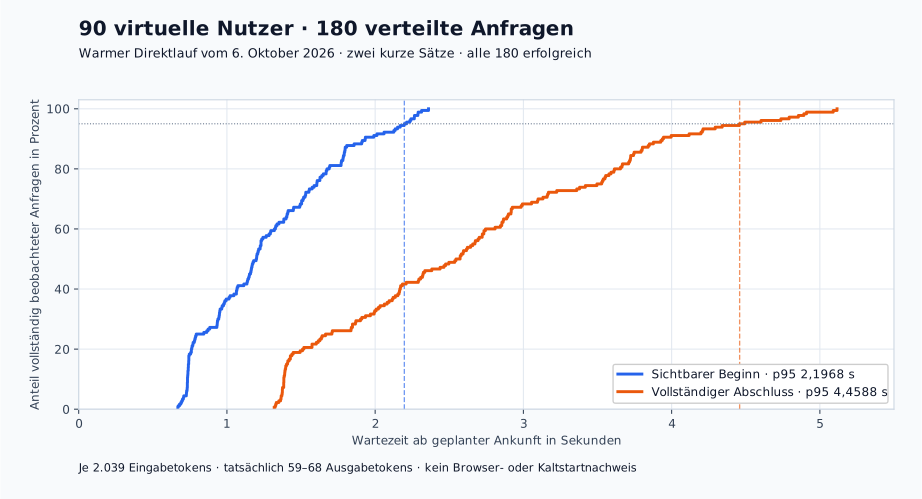
Die Messung erfüllt für dieses Profil die vorgeschlagenen Ziele von höchstens fünf Sekunden bis zum sichtbaren Beginn und höchstens 60 Sekunden bis zum vollständigen Abschluss bei p95. Die fachliche Qualität der Antworten und die Benutzung über die Oberfläche werden damit nicht beurteilt.
4. Gemeinsame Starts, lange Eingaben und Thinking
Die Stufen bis 32 gemeinsamen Ankünften waren in jeweils drei Serien vollständig erfolgreich. Im ersten Versuch mit 64 Ankünften fehlten vier Abschlüsse. Eine getrennte neue 64er-Messung und die anschließende 90er-Messung endeten vollständig. Bei gemeinsamen Starts steigen die Wartezeiten, weil Anfragen gleichzeitig ankommen und auf freie Rechenplätze warten können.
| Gemeinsame Ankünfte / Serie | Erfolgreich | Sichtbar min / Median / max | Vollständig min / Median / max | p95 |
|---|---|---|---|---|
| 1 | 3/3 | 0,744 s / 0,745 s / 0,747 s | 1,392 s / 1,395 s / 1,416 s | — |
| 2 | 6/6 | 1,095 s / 1,2425 s / 1,341 s | 2,035 s / 2,1815 s / 2,299 s | — |
| 4 | 12/12 | 1,742 s / 1,772 s / 1,867 s | 2,711 s / 2,962 s / 3,027 s | — |
| 8 | 24/24 | 2,86 s / 2,95 s / 3,086 s | 4,315 s / 4,3765 s / 4,479 s | — |
| 16 | 48/48 | 5,013 s / 5,281 s / 5,491 s | 7,028 s / 7,288 s / 7,434 s | — |
| 24 | 72/72 | 7,207 s / 7,421 s / 7,629 s | 9,609 s / 9,7975 s / 10,027 s | — |
| 32 | 96/96 | 9,481 s / 9,85 s / 10,512 s | 12,233 s / 12,6305 s / 13,373 s | — |
| 64 ursprünglich, 6.10. | 60/64 | 9,33 s / 10,0995 s / 21,916 s | 12,265 s / 19,3285 s / 24,476 s | — |
| 64 neu, 7.10. | 64/64 | 9,952 s / 16,074 s / 22,452 s | 12,544 s / 21,616 s / 25,101 s | — |
| 90 neu, 7.10. | 90/90 | 9,321 s / 21,6975 s / 32,593 s | 12,041 s / 26,8075 s / 34,948 s | — |
Je Nutzerstufe liegen weniger als 100 erfolgreiche Beobachtungen vor. Deshalb werden Minimum, Median und Maximum angegeben. Für diese Stufen wird kein p95 veröffentlicht. Die Zeiten des ursprünglichen 64er-Versuchs beschreiben seine 60 erfolgreichen Antworten. Die vier fehlenden Antworten bleiben in der Bilanz erhalten.
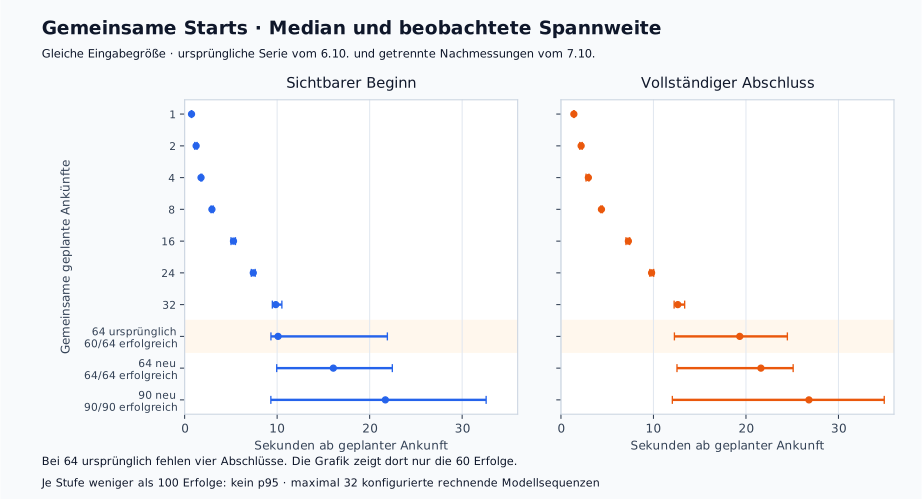
Im neuen 90er-Versuch begann die sichtbare Antwort im Median nach 21,70 Sekunden und war nach 26,81 Sekunden vollständig. Der langsamste sichtbare Beginn lag bei 32,593 Sekunden, der langsamste Abschluss bei 34,948 Sekunden. Keine dieser 90 Antworten begann sichtbar innerhalb von fünf Sekunden. Ein Fünf-Sekunden-Ziel für einen solchen gemeinsamen Start ist deshalb nicht erfüllt. Die verteilten 180 Anfragen erfüllen ihr eigenes Wartezeitziel. Die gemeinsame Startmessung belegt kurze Antworten in diesem konkreten Versuch, keine beliebig große Dauerlast.
Begrenzte längere Eingaben und Thinking
Alle 22 Fälle mit längeren Eingaben und alle 14 Thinking-Anfragen wurden vollständig beantwortet. Die längeren Eingaben wurden mit geringer Parallelität geprüft. Die folgende Tabelle fasst jeweils die geplanten Einzel- und Parallelversuche zusammen.
| Profil | Eingabe (Tokens) | Parallele Ankünfte | Erfolg | Sichtbar min / Median / max | Vollständig min / Median / max |
|---|---|---|---|---|---|
| Instant. langer Verlauf | 8.189 | 1, 2 und 4, je zweimal | 14/14 | 1,568 s / 5,3165 s / 5,462 s | 2,294 s / 6,789 s / 6,959 s |
| Instant. großer Kontext | 16.379 | 1 und 2, je zweimal | 6/6 | 2,971 s / 5,635 s / 5,754 s | 3,769 s / 6,7645 s / 6,915 s |
| Instant. großer Kontext | 29.999 | 1, zweimal | 2/2 | 5,914 s / 6,103 s / 6,292 s | 6,744 s / 7,0095 s / 7,275 s |
| Thinking | 2.039 | 1, 2 und 4, je zweimal | 14/14 | 2,528 s / 4,664 s / 6,45 s | 3,158 s / 5,6775 s / 7,565 s |
Bei rund 8.000 Eingabetokens wurden höchstens vier, bei rund 16.000 höchstens zwei und bei rund 30.000 jeweils eine Anfrage gleichzeitig geprüft. Das belegt keine 32 gleichzeitig vollständig gefüllten Kontexte. Die Thinking-Antworten umfassten tatsächlich 149 bis 236 gemeldete Ausgabetokens. Auch für diese kleinen Stichproben wird kein p95 angegeben.
Bei den vier ursprünglichen Fehlanfragen kam keine sichtbare Antwort am Messclient an. Die erfolgreichen Nachmessungen erklären diese frühere Ursache nicht rückwirkend.
5. Frontendlauf: das vollständige Ziel ist nicht bestanden
Alle 90 Testkonten konnten sich anmelden, ihre Sitzung und Bereitschaft prüfen und sich wieder abmelden. Insgesamt wurden 121 Chatanfragen tatsächlich abgeschickt. Davon endeten 117 erfolgreich, vier nach dem Start ohne Erfolg. Weitere 68 vorgesehene Anfragen der 90er-Stufe wurden nicht gestartet. Diese 72 nicht vollständig erfolgreichen vorgesehenen Anfragen sind keine 72 tatsächlichen HTTP-Fehler.
| Stufe | Vorgesehen | HTTP-Anfragen | Erfolge | Nach Start ohne Erfolg | Nicht gestartet |
|---|---|---|---|---|---|
| Grundprüfung | 9 | 9 | 9 | 0 | 0 |
| 90 Personen, je zwei Anfragen | 180 | 112 | 108 | 4 | 68 |
| Gemeinsame Chatlast | 180 | 0 | 0 | 0 | 180 |
| Gesamter Chatplan | 369 | 121 | 117 | 4 | 248 |
Die folgenden Wartezeiten gelten ausschließlich für erfolgreich abgeschlossene Antworten. Die 108 erfolgreichen Antworten der 90er-Stufe bilden eine Teilmenge. Sie ersetzen keine vollständige Messung aller 180 vorgesehenen Anfragen.
| Stichprobe | Anzahl | Sichtbar min / Median / max | p95 sichtbar | Vollständig min / Median / max | p95 vollständig |
|---|---|---|---|---|---|
| Grundprüfung | 9 | 2,156 s / 3,848 s / 6,609 s | — | 8,329 s / 12,056 s / 12,089 s | — |
| Erfolgreiche Teilmenge der 90er-Nutzung | 108 | 1,389 s / 4,2385 s / 8,42 s | 7,70245 s | 2,35 s / 13,068 s / 17,753 s | 16,37525 s |
Für die Grundprüfung mit neun Antworten wird kein p95 veröffentlicht. Das sichtbare p95 der 108 erfolgreichen Antworten liegt bei 7,70245 Sekunden und damit über dem vorgeschlagenen Fünf-Sekunden-Ziel. Ein vollständiges p95 für die 180 vorgesehenen Anfragen ist daraus nicht ableitbar.
Was die Abweisung für mehrere Klassen bedeutet
Der Lauf nahm 120 Chataufträge an und wies eine weitere Anfrage mit HTTP 429 ab. Der dokumentierte Produktstandard erlaubt schulweit 120 neue KI-Aufträge in zehn Minuten. Zwei Anfragen von 90 Personen ergeben 180 Aufträge in fünf Minuten. Dieses Unterrichtsprofil passt nicht zu der Standardregel. Eine erfolgreiche Anmeldung aller Personen ist deshalb keine Zusage, alle ihre Anfragen sofort anzunehmen.
Ein künftiger Unterrichtsplan muss die gewünschte Anfragemenge und Wartezeit mit der schulweiten Aufnahme abstimmen. Bei unveränderter Schutzregel müssen Anfragen über längere Zeit verteilt werden. Für mehr Aufträge und kurze Wartezeiten braucht es eine gesondert geprüfte Anpassung von Aufnahme und Queue. Beim Abschluss der Lastdiagnose wurde keine Schutzregel verändert und kein weiterer Modelllauf gestartet.
Leistungsanzeige und Grenzen
Bei allen 117 erfolgreichen Chats war die Leistungsanzeige verfügbar, jeweils mit zwei GPU-Messpunkten. Der Runtimeadapter erfasste 236 Verbindungen ohne Fehler. Das belegt die Funktion während dieses Lastlaufs. Zwei Punkte je Antwort ergeben keine vollständige Leistungskurve oder Bewertung des gesamten Stromverbrauchs. Energiewerte gleichzeitig laufender Chats werden nicht als Gesamt-Systemenergie addiert.
Eine Messung über die Anwendungsschnittstellen und Chatworker ersetzt keine vollständige Prüfung von 90 gleichzeitig geöffneten Browsern. Die verteilten direkten Anfragen, gemeinsame Starts, lange Eingaben und Thinking bleiben getrennte Profile.
Die gemeinsame Last mit 60 Quellen- und 20 Vorleseanfragen wurde nicht gestartet und bleibt ungeprüft. Frühere Vorbereitungsprobleme des Messaufbaus bleiben als eigene Befunde erhalten. Der geschützte Sitzungsprotokollabruf besteht bereits als getrennte Funktionsprobe, gehört aber nicht zu dieser Kapazitätsmessung.
6. Messgrenzen, Ressourcen und Datenschutz
Die frischen Nachkontrollen der direkten Messungen bestätigen erhaltene Betriebsbindungen und Modelleinstellungen sowie keine laufenden oder wartenden Inferenzanfragen. Die beobachteten OOM-Zähler blieben bei null. Die Modelleinstellungen wurden während dieser Messungen nicht verändert.
GPU-Speicher und GPU-Leistungsaufnahme wurden in den direkten Lastläufen nicht gemessen. Der Frontendlauf enthält die getrennt beschriebenen wenigen GPU-Leistungsstichproben. Die Modellgewichte wurden nicht erneut inhaltlich gehasht. Kaltstart, beliebig lange Antworten und große gleichzeitige Kontexte sind durch diese Ergebnisse nicht abgenommen. Die gemeinsame Chat-, Quellen- und Vorleselast bleibt ungeprüft.
Die Streams enthielten Denktext, obwohl die Tokenstatistik dafür jeweils null meldete. Daraus wird keine Rate für rein sichtbare Ausgabetokens abgeleitet. Die Juni-Kennzahl „erster Token“ kann Denktext einbeziehen und ist deshalb nicht präzise mit dem heutigen sichtbaren Antwortbeginn gleichzusetzen.
Die Messungen speichern technische Kennzahlen. Echte Schülerdaten, Chattexte, Zugangsschlüssel und vollständige Modellantworten gehören nicht in die veröffentlichten Ergebnisse. Die beiden Befunde zur Lastdiagnose und die Korrekturen an Messadapter und Erreichbarkeitsprüfung wurden am 7. Oktober 2026 durch Grok 4.7 unabhängig bestätigt. Diese Prüfung betrifft die Messwerkzeuge. Sie erteilt weder eine Kapazitätsfreigabe für 90 Personen noch eine allgemeine Sicherheitsfreigabe des Backends. Weitere formale Backend-Sicherheitsprüfungen bleiben offen.
7. Historische Referenz vom Juni 2026
Der vollständige Instant-Lauf mit gleichzeitigen Starts und der vollständige Instant-Lauf mit verteilten Starts bleiben erhalten. Der Thinking-Lauf wurde nur teilweise durchgeführt und ist keine vollständige Kapazitätsmessung.
Was genau gemessen wird
Die Benchmarks messen ausschließlich die Inferenzstrecke der Spark. Frontend, Browser, Anmeldung, Session-Verwaltung, Chatoberfläche, Projektlogik, Datei-Retrieval und echte Unterrichtsabläufe sind nicht Teil dieser Messung. Die Ergebnisse beschreiben also die technische Antwortleistung des lokalen Modells unter synthetischer Last.
Verwendet wurden synthetische deutschsprachige Prompts aus typischen Schulkontexten: Erklärungen, kurze Wissensfragen, Strukturierungsaufträge und mathematisch-logische Aufgaben. Echte Nutzerfragen, echte Chatverläufe und Projektinhalte wurden nicht verwendet. Antworttexte wurden für die Veröffentlichung nicht gespeichert.
| Merkmal | Gemessener Stand |
|---|---|
| Modus | Instant; ergänzender Thinking-Kontrolllauf |
| Reasoning-Stufe | Instant mit kurzer Antwortführung; Thinking mit zusätzlicher Denkzeit |
| Modellpfad | Lokaler Schul-Inferenzdienst |
| Prompt-Typ | Synthetische deutschsprachige Unterrichtsprompts |
| Inhaltsspeicherung | Keine veröffentlichten Antworttexte, keine echten Nutzerdaten |
Kennzahlen richtig lesen
Ein Lasttest ist nur nützlich, wenn die Kennzahlen richtig gelesen werden. Eine niedrige Fehlerquote sagt: Die Anfragen wurden technisch verarbeitet. Sie sagt aber nicht, dass sich die Nutzung unter Last angenehm anfühlt.
| Kennzahl | Bedeutung | Warum sie wichtig ist |
|---|---|---|
| p50 | Median: Die Hälfte der Anfragen ist schneller, die andere Hälfte langsamer. | Beschreibt den typischen Fall. |
| p95 | 95 Prozent der Anfragen sind schneller als dieser Wert, 5 Prozent langsamer. | Zeigt die langsamen Fälle, die im Unterricht als störend wahrgenommen werden. |
| Zeit bis zum ersten Token | Zeit, bis die Antwort sichtbar zu beginnen scheint. | Bestimmt stark das Nutzergefühl: „Ephraim arbeitet“ oder „es passiert nichts“. |
| Gesamtlatenz | Zeit bis zum Abschluss der Antwort. | Zeigt, wann der vollständige Text vorliegt. |
| Durchsatz | Erfolgreiche Antworten pro Minute. | Ein Plateau zeigt, dass zusätzliche Last vor allem Wartezeit erzeugt. |
Zwei Szenarien
Die vorhandenen Instant-Läufe bestehen aus zwei unterschiedlichen Lastbildern. Beide sind wichtig, weil Schulen sowohl harte Spitzen als auch verteilte Nutzung erleben.
| Szenario | Was simuliert wird | Was daraus gelesen wird |
|---|---|---|
| Gleichzeitigkeit | 1 bis 90 virtuelle Nutzer starten exakt gleichzeitig; jede Stufe wird dreimal wiederholt. | Wie die Spark auf harte Lastspitzen reagiert. |
| Fünf-Minuten-Szenario | 50, 100 oder 200 Nutzer starten zufallsverteilt innerhalb von 300 Sekunden. | Wie sich eine natürlichere Unterrichtslast über mehrere Minuten anfühlt. |
Das Fünf-Minuten-Szenario ist für Schulbetrieb besonders aussagekräftig. Auch wenn viele Personen mit Ephraim arbeiten, verteilen sich echte Fragen meist über Minuten: Einige lesen, andere überarbeiten, andere diskutieren, wieder andere stellen Folgefragen.
Ergebnis: Gleichzeitige Nutzer
Der Gleichzeitigkeitstest vom 03.06.2026 schloss 723 von 723 Messanfragen erfolgreich ab. Die Fehlerquote lag in allen Stufen bei null Prozent. Gleichzeitig zeigt der Lauf eine deutliche Sättigungskurve: Ab etwa 24 bis 32 gleichzeitig gestarteten Anfragen wird die interne Warteschlange sichtbar.
| Gleichzeitige Nutzer | Erfolgreich | Fehlerquote | p50 Latenz | p95 Latenz | p50 erster Token | p95 erster Token | Durchsatz |
|---|---|---|---|---|---|---|---|
| 1 | 3/3 | 0 % | 6,8 s | 8,8 s | 0,2 s | 0,2 s | 20,0/min |
| 2 | 6/6 | 0 % | 10,3 s | 11,3 s | 0,3 s | 0,3 s | 31,4/min |
| 4 | 12/12 | 0 % | 16,4 s | 17,7 s | 0,3 s | 0,3 s | 40,4/min |
| 8 | 24/24 | 0 % | 20,5 s | 24,2 s | 0,3 s | 0,3 s | 58,4/min |
| 16 | 48/48 | 0 % | 27,9 s | 32,9 s | 0,3 s | 13,1 s | 76,7/min |
| 24 | 72/72 | 0 % | 34,5 s | 57,5 s | 0,4 s | 30,6 s | 72,7/min |
| 32 | 96/96 | 0 % | 51,3 s | 69,4 s | 22,3 s | 47,6 s | 79,9/min |
| 64 | 192/192 | 0 % | 78,3 s | 135,3 s | 50,0 s | 108,2 s | 78,5/min |
| 90 | 270/270 | 0 % | 108,1 s | 196,3 s | 73,7 s | 163,2 s | 75,5/min |
Der Durchsatz steigt zuerst an und erreicht dann ein Plateau im Bereich von etwa 75 bis 80 Antworten pro Minute. Zusätzliche Gleichzeitigkeit erhöht den Durchsatz danach nicht mehr wesentlich, sondern verlängert vor allem die Wartezeit.
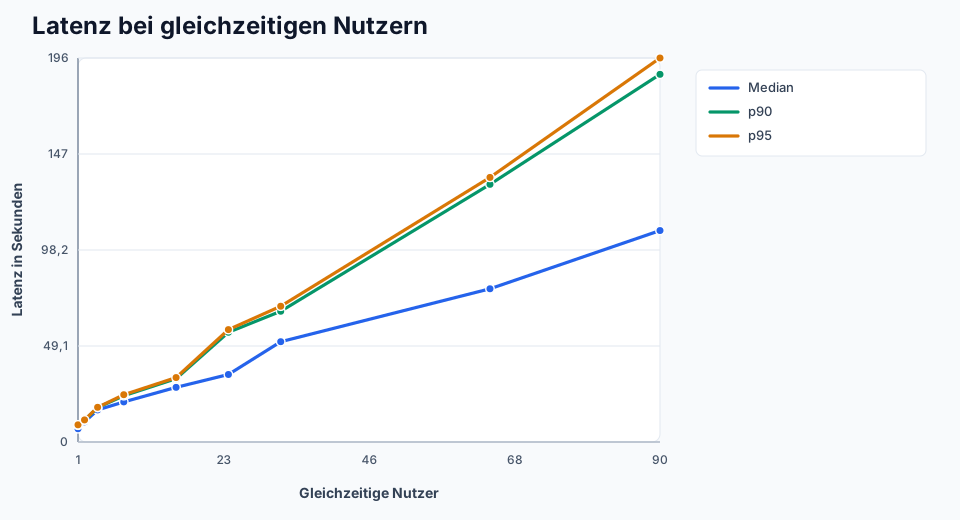
So liest man das Diagramm: Die waagerechte Achse zeigt die Zahl gleichzeitig gestarteter Nutzerinnen und Nutzer, die senkrechte Achse die Sekunden bis zur fertigen Antwort. p50 beschreibt den typischen Fall, p90 und p95 die langsameren Fälle. Wichtig ist der Knick ab etwa 24 bis 32 gleichzeitigen Starts: Ab dort wächst vor allem die Wartezeit in der Queue.
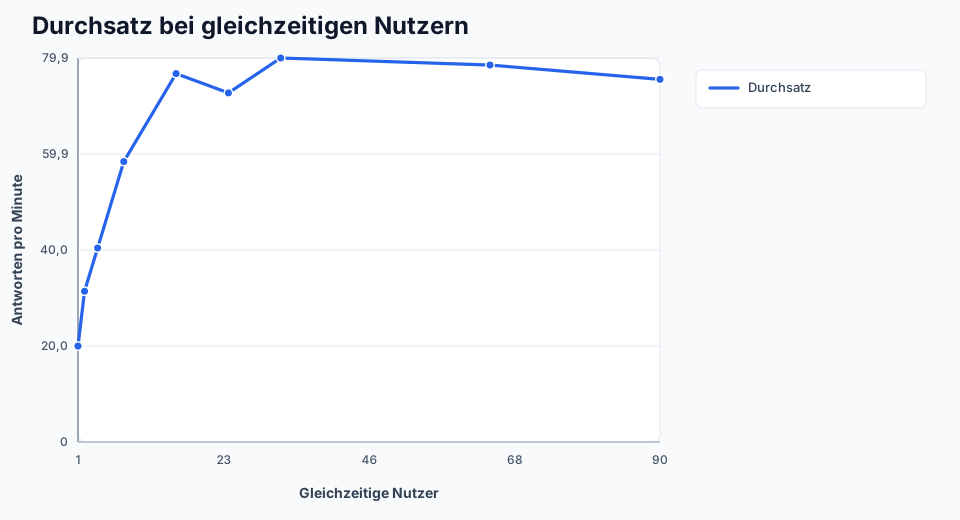
So liest man das Diagramm: Die waagerechte Achse zeigt wieder die gleichzeitigen Starts, die senkrechte Achse die erfolgreich abgeschlossenen Antworten pro Minute. Eine steigende Linie bedeutet, dass zusätzliche Last noch in mehr abgeschlossene Antworten umgesetzt wird. Das Plateau bei etwa 75 bis 80 Antworten pro Minute zeigt die praktische Kapazitätsgrenze dieses Laufs.
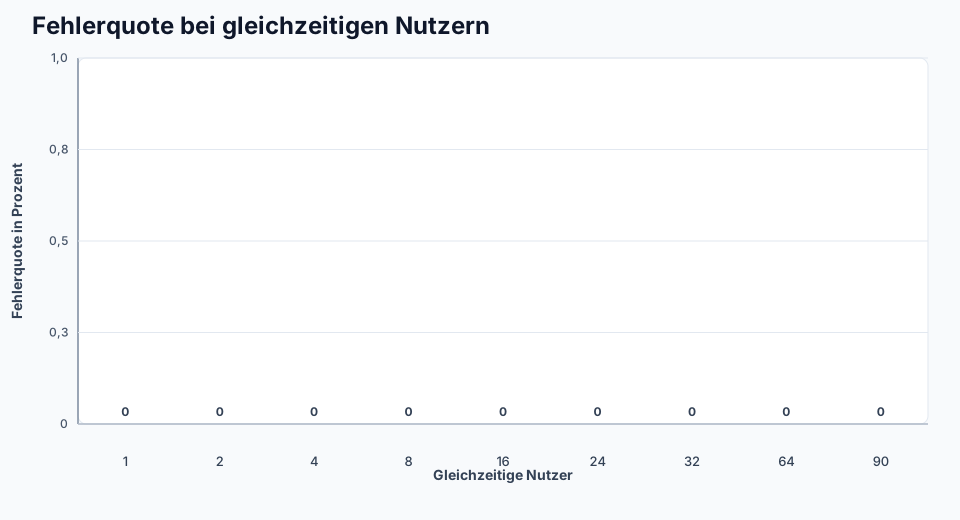
So liest man das Diagramm: Jede Säule steht für eine Laststufe, die senkrechte Achse zeigt den Anteil fehlgeschlagener Anfragen. Null Prozent in allen Stufen bedeutet: Die Anfragen wurden technisch angenommen und abgeschlossen. Für das Nutzergefühl müssen trotzdem die Latenzgrafiken daneben gelesen werden.
Ergebnis: Zufallsverteilte Anfragen
Das Fünf-Minuten-Szenario vom 04.06.2026 schloss 350 von 350 Messanfragen erfolgreich ab. Aus Schulsicht ist dieses Szenario besonders wichtig, weil Unterrichtslast selten exakt gleichzeitig entsteht.
| Virtuelle Nutzer in 5 Minuten | Erfolgreich | Fehlerquote | Max. Parallelität | p50 Latenz | p95 Latenz | p50 erster Token | p95 erster Token | Durchsatz |
|---|---|---|---|---|---|---|---|---|
| 50 | 50/50 | 0 % | 6 | 15,1 s | 23,0 s | 0,3 s | 0,4 s | 9,5/min |
| 100 | 100/100 | 0 % | 17 | 27,3 s | 37,0 s | 0,4 s | 0,5 s | 18,6/min |
| 200 | 200/200 | 0 % | 71 | 94,0 s | 144,3 s | 62,9 s | 114,0 s | 27,4/min |
50 zufallsverteilte Anfragen in fünf Minuten sind in diesem Lauf unproblematisch. Auch 100 zufallsverteilte Anfragen sehen für reale schulische Nutzung gut aus: alle Anfragen waren erfolgreich, die p95-Gesamtlatenz lag bei 37 Sekunden und die Zeit bis zum ersten Token blieb niedrig.
200 zufallsverteilte Anfragen in fünf Minuten zeigen die Reserve und die Grenze zugleich: Ephraim bleibt stabil, aber die p50-Zeit bis zum ersten Token steigt auf 62,9 Sekunden. Der Benchmark-Runner selbst startete die Anfragen pünktlich. Die Verzögerung entsteht nach Annahme der Anfragen in der Inferenz-Abarbeitung.
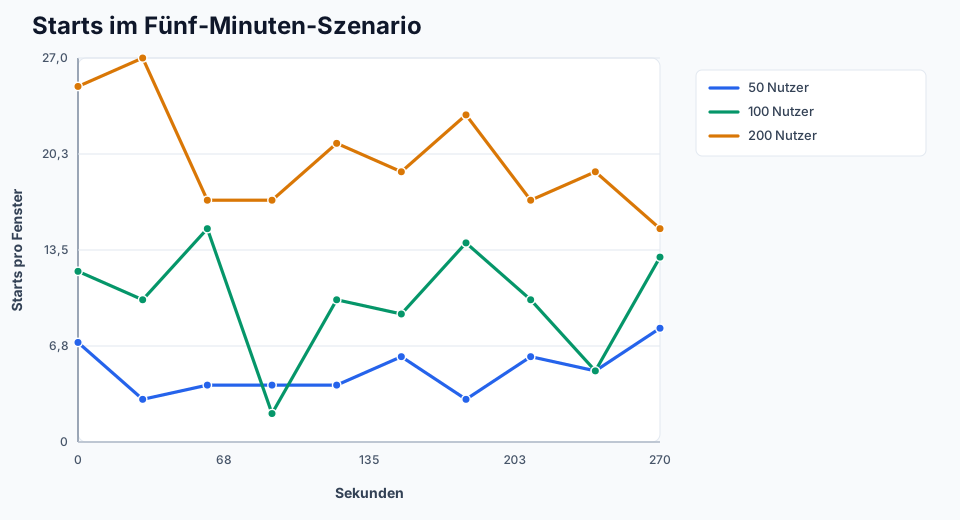
So liest man das Diagramm: Die waagerechte Achse zeigt die fünf Minuten in Zeitfenstern, die senkrechte Achse die neu gestarteten Anfragen je Fenster. Einzelne Spitzen sind bei Zufallsverteilung normal. Entscheidend ist, wie dicht mehrere Spitzen aufeinander folgen, weil genau dann die Warteschlange schnell wächst.
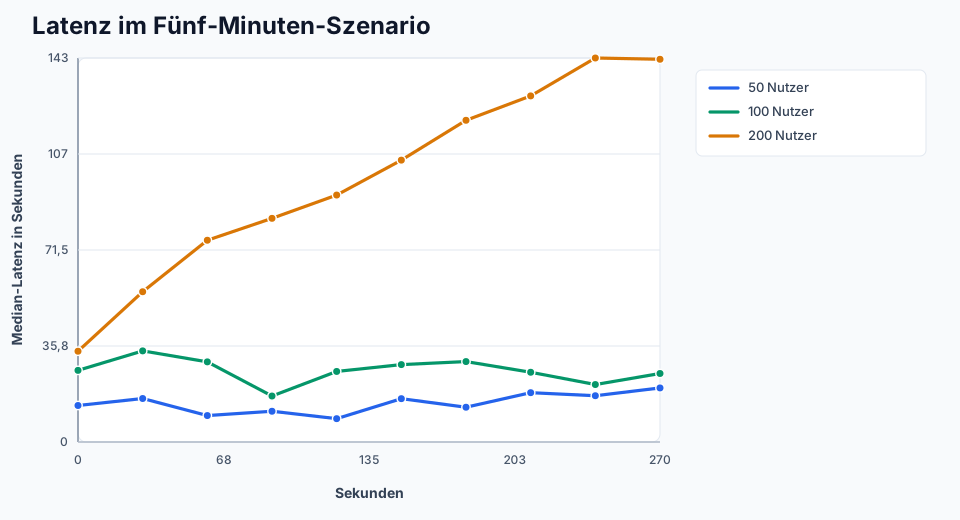
So liest man das Diagramm: Die waagerechte Achse zeigt den Verlauf des Messzeitraums, die senkrechte Achse die typische Gesamtdauer abgeschlossener Antworten. Eine stabile Linie bedeutet, dass die Spark ungefähr so schnell abarbeitet, wie neue Arbeit hinzukommt. Eine steigende Linie zeigt, dass die Queue wächst und spätere Anfragen länger warten müssen.
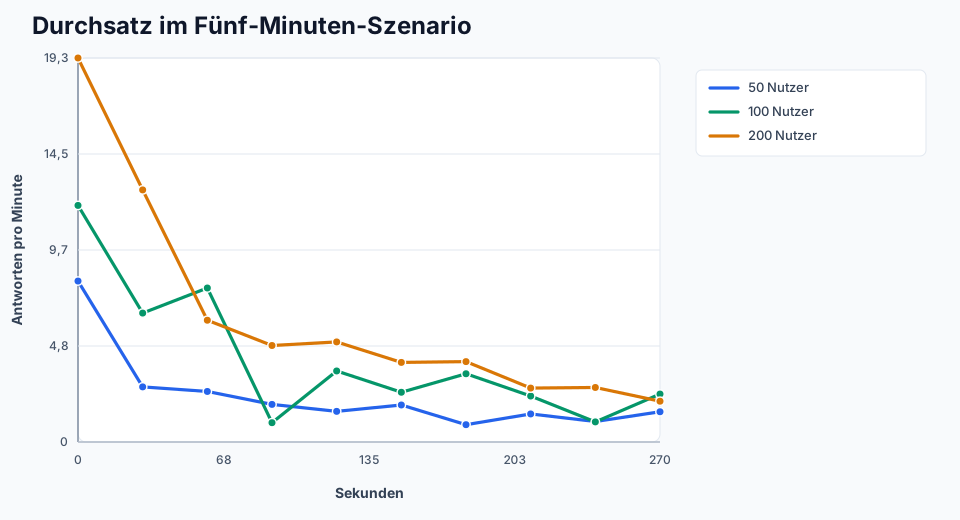
So liest man das Diagramm: Die waagerechte Achse zeigt die Zeit, die senkrechte Achse die abgeschlossenen Antworten pro Minute. Die Kurve darf der Startgrafik nicht eins zu eins entsprechen: Starts erzeugen Arbeit, Durchsatz zeigt erledigte Arbeit. Wenn viele Starts auftreten, der Durchsatz aber nicht entsprechend steigt, wird die überschüssige Arbeit in der Queue gespeichert.
Warum die Warteschlange kein Fehler ist
Eine Warteschlange klingt zunächst negativ. Für ein Schulsystem ist geordnetes Abarbeiten aber besser als aggressive Fehler. Ohne Queue müsste ein überlasteter Inferenzdienst Anfragen ablehnen, Verbindungen abbrechen oder unzuverlässig reagieren. Mit Queue bleiben Anfragen erhalten und die Spark kann ihre Rechenkapazität kontinuierlich nutzen.
Die Kehrseite ist das Nutzergefühl: Wenn eine Anfrage angenommen wurde, aber lange kein erster Antwortteil erscheint, wirkt die Oberfläche schnell unklar. Deshalb sollte Ephraim bei hoher Last verständlich signalisieren, dass die Anfrage angenommen wurde und in Arbeit ist. Für Admins sind First-Token-Zeit, aktive Requests und künftig Queue-Signale die wichtigsten Frühwarnwerte.
Instant und Thinking einordnen
Thinking wurde nicht als vollständiger Lasttest zu Ende geführt. Das ist fachlich vertretbar, weil der Kontrolllauf bereits die entscheidende Beobachtung zeigte: Der Start der Antwort ist nicht das Problem. Die erste sichtbare Ausgabe kam fast genauso schnell wie bei Instant. Länger wird vor allem die Zeit bis zur vollständigen Antwort, weil Thinking mehr Rechenarbeit pro Anfrage investiert.
| Laststufe | Modus | Erfolgreich | p50 Latenz | p50 erster Token | Durchsatz |
|---|---|---|---|---|---|
| 1 gleichzeitiger Nutzer | Instant | 3/3 | 6,8 s | 0,2 s | 20,0/min |
| 1 gleichzeitiger Nutzer | Thinking | 3/3 | 9,8 s | 0,2 s | 18,3/min |
| 2 gleichzeitige Nutzer | Instant | 6/6 | 10,3 s | 0,3 s | 31,4/min |
| 2 gleichzeitige Nutzer | Thinking | 6/6 | 13,8 s | 0,3 s | 25,1/min |
Für Admins ist diese Unterscheidung wichtig: Thinking ist nicht „kaputt langsam“, sondern pro Anfrage rechenintensiver. Es ist deshalb plausibel, dass ein vollständiger Thinking-Lasttest bei hohen Nutzerzahlen vor allem längere Warteschlangen zeigen würde. Für den normalen Kapazitätsvergleich reicht Instant als Hauptmessung, solange Thinking bewusst als Qualitätsmodus mit längerer Fertigstellung kommuniziert wird.