Chat: Sprachausgabe
Ephraim kann Chatantworten und ausgewählte Chatteile vorlesen. Der native S2-Pro-Dienst auf der schuleigenen Spark erzeugt die Sprachausgabe. Er erkennt die Sprache automatisch. Die Webanwendung nutzt keinen Browser- oder Cloud-Fallback.
1. Was vorgelesen wird
Vorgelesen werden fertige Chatinhalte. Während eine Antwort noch entsteht, wartet Ephraim, bis der Stream abgeschlossen ist. Dadurch hörst du keinen halben Zwischenstand und keine noch unfertige Satzfolge.
Die Sprachausgabe ist für typische Arbeitssituationen gedacht: eine Erklärung noch einmal hören, einen längeren Text auditiv prüfen, eine Antwort in der Fremdsprache anhören oder ausgewählte Chatteile für konzentriertes Arbeiten vorlesen lassen.
2. Auswahl und Player
Der Vorlesedialog nutzt dieselbe Grundidee wie die Exportauswahl: Du entscheidest, welcher Teil des Chats in eine andere Form gebracht wird. Je nach Chatstand sind mehrere Umfänge möglich.
| Auswahl | Was Ephraim liest |
|---|---|
| Letzte Antwort | Nur die letzte fertige Antwort von Ephraim. |
| Letzte Frage mit Antwort | Die letzte Nutzerfrage und die zugehörige Antwort. |
| Aktuelle Auswahl | Die Nachrichten, die du vorher im Chat markiert hast. |
| Ganzer Chat | Alle sichtbaren Nachrichten des geöffneten Chats. |
| Nur Antworten | Nur die Antworten von Ephraim, ohne deine Zwischenfragen. |
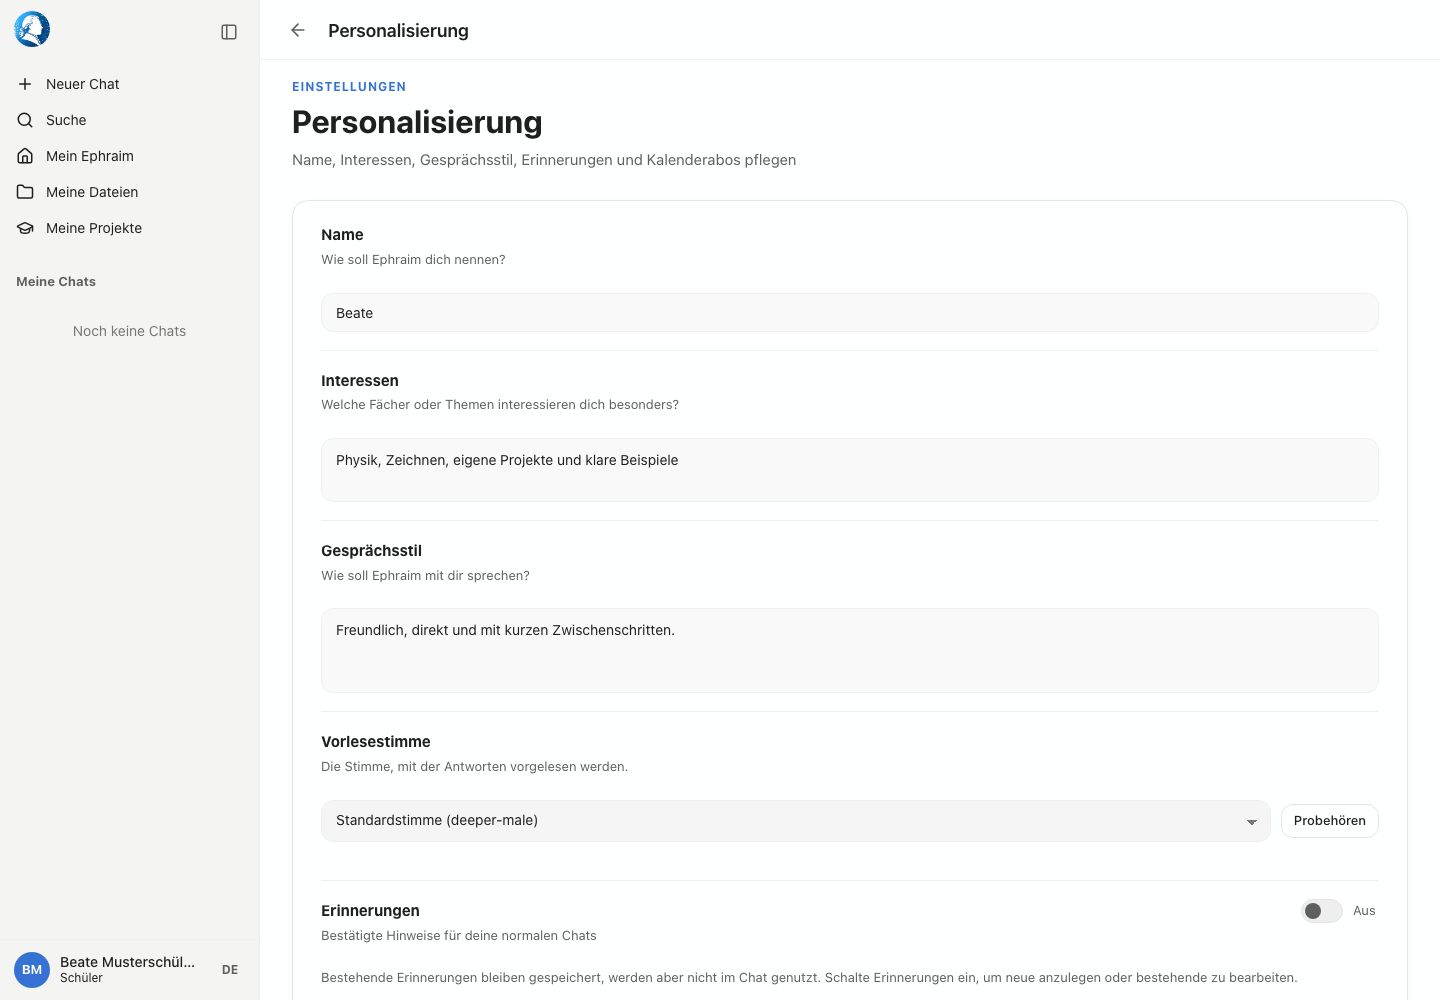
Unter „Einstellungen → Personalisierung → Vorlesestimme“ können normale Konten eine angebotene Stimme wählen und probehören. Die Auswahl wird für das Konto gespeichert. Die Wiedergabe kann gestartet, pausiert, fortgesetzt und gestoppt werden. Beim Wechsel des Chats, beim Start eines neuen Gesprächs oder beim Schließen der Chatansicht stoppt Ephraim die Wiedergabe, damit keine alte Audiospur in einen anderen Arbeitskontext hineinläuft.
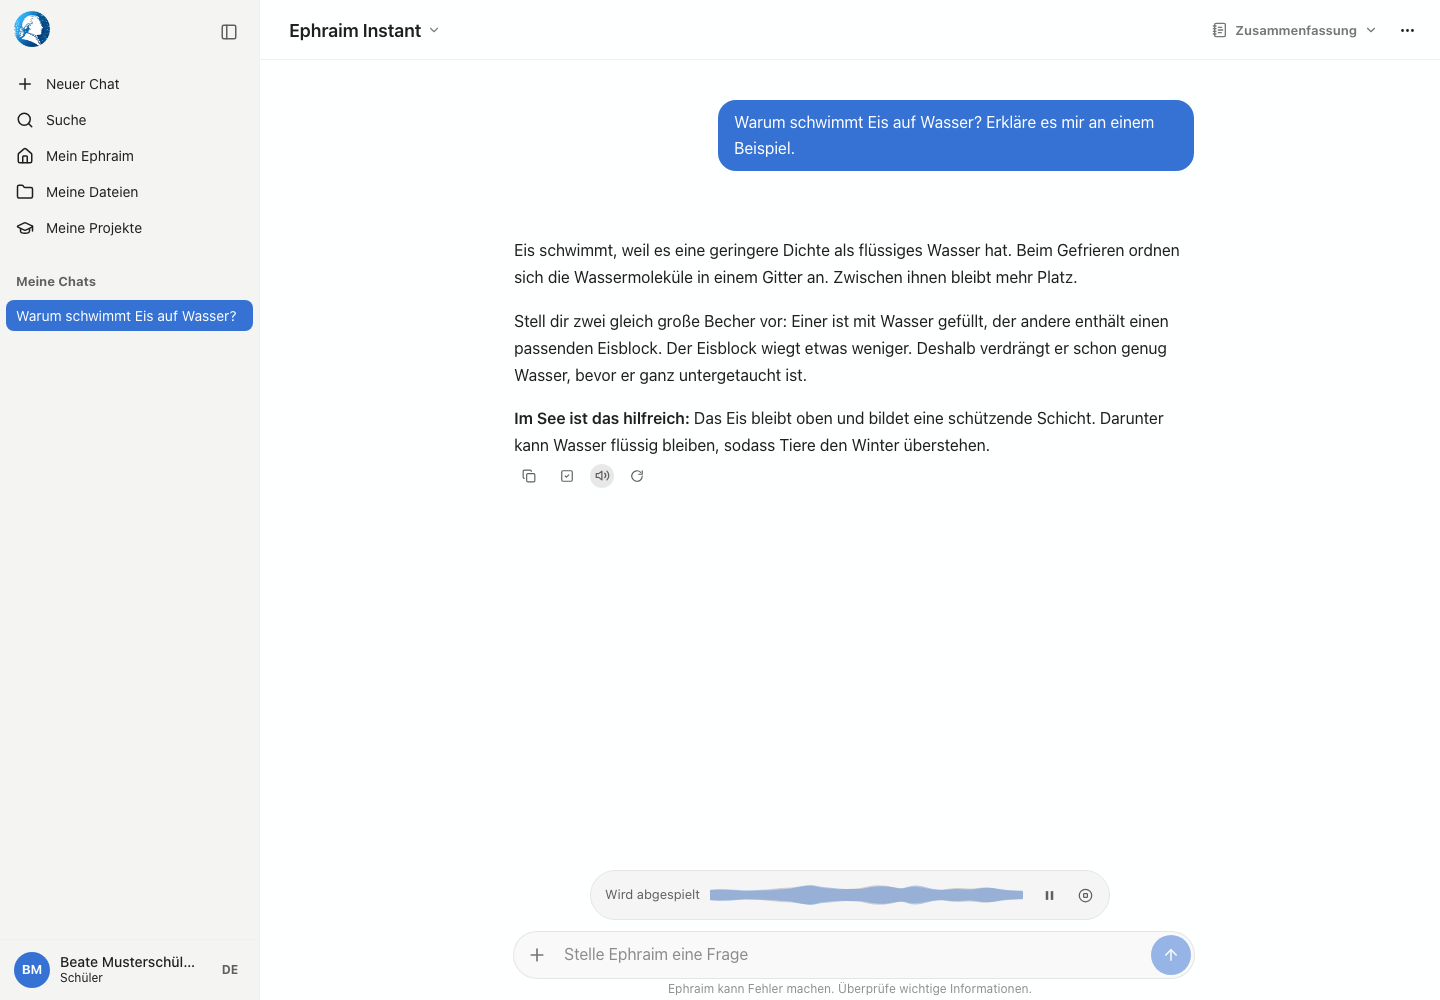
Der Player zeigt den Wiedergabezustand und eine Wellenform. Eine Gesamtdauer oder Prozentanzeige gibt es während der laufenden Spracherzeugung nicht, weil noch nicht feststeht, wie lang das Audio wird. Ephraim puffert zunächst einige Sekunden. Bei hoher Last können zusätzliche Wartepausen zwischen Textabschnitten entstehen.
3. Sprachen und gemischte Texte
S2-Pro ist ein mehrsprachiger Sprachdienst und erkennt die Sprache aus dem zu lesenden Text. Eine fremdsprachige Sprachausgabe ist von der Sprache der Bedienoberfläche zu unterscheiden. Eine Sprach- oder Tempoeinstellung wird dem aktuellen Synthesedienst nicht übergeben.
Eine Antwort kann eine deutsche Erklärung, ein französisches Zitat und englische Fachbegriffe enthalten. Ephraim bereitet die ausgewählten Nachrichten als lesbaren Text vor und übergibt sie an S2-Pro. Die Aussprache und der Umgang mit Sprachwechseln hängen dabei von der automatischen Spracherkennung des Dienstes ab. Die Webanwendung garantiert keine ausdrückliche Sprachumschaltung je Satz.
Auch gespeicherte Sprachhinweise einer Antwort erzwingen im aktuellen Vorlesepfad keine Sprache im Synthesedienst. Der Player erhält einen Audiostream aus der gewählten Stimme. Pausieren und Stoppen steuern diese lokale Wiedergabe und sind von der Spracherzeugung auf der Spark zu unterscheiden.
4. Wie Text für das Vorlesen vorbereitet wird
Ephraim liest nicht den rohen Markdown-Code vor, sondern die gerenderte Chatdarstellung. Dadurch klingen Listen, Tabellen, Formeln und Visualisierungen verständlicher.
| Element | Vorleselogik |
|---|---|
| Tabellen | Die Tabelle wird als Tabelle mit Spalten und Zeilen beschrieben. |
| Codeblöcke | Lange Codeblöcke werden zusammengefasst, statt Zeichen für Zeichen vorgelesen zu werden. |
| Formeln | Formeln werden als Formeln markiert, damit sie nicht als unverständliche Rohzeichenfolge erscheinen. |
| Visualisierungen | Diagramme, Zeichnungen oder Strukturformeln werden mit Titel und fachlicher Beschreibung vorgelesen. |
| Anhänge | Dateien werden mit Name, Typ und Größe beschrieben. |
5. Warum die Spark dafür wichtig ist
Der Browser sendet den ausgewählten Text an den Ephraim-Webserver. Dieser prüft Anmeldung, CSRF-Schutz, Größen- und Aufnahmegrenzen und ruft den internen S2-Pro-Dienst auf der Spark auf. Im Produktivbetrieb erfolgt dieser Backendabruf ausschließlich per HTTPS. Die ausgewählte Stimme kommt aus der Stimmenregistry. Sowohl Stimmenabruf als auch Synthese benötigen den serverseitigen Bearer-Token. Der Browser kennt weder diesen Token noch die interne Dienstadresse.
S2-Pro streamt rohe Audioteile. Der Webserver leitet sie in begrenzten PCM-Paketen an den Browser weiter, ohne eine Audiodatei auf der Serverplatte anzulegen. Im Browser werden die Teile in flüchtigen Web-Audio-Puffern gesammelt und abgespielt. Die lokale Anzeige wird daraus berechnet. Der aktuelle Weg verwendet weder eine vollständig gepufferte WAV-Datei noch einen Audio-Blob als Wiedergabequelle.
Ist Spark-TTS nicht eingerichtet, bleibt die Vorlesefunktion deaktiviert. Ephraim fällt nicht auf die Web-Speech-Funktion des Browsers zurück. Das ist eine bewusste Grenze: Die Schule entscheidet, welcher lokale Dienst Text in Audio umwandelt.
6. Datenschutz und Grenzen
Für die Sprachausgabe muss der ausgewählte Text kurzzeitig im Klartext verarbeitet werden. Diese Verarbeitung bleibt bei der Webanwendung und dem eingerichteten internen Spark-Dienst. Die erzeugten Audioteile und die Anzeige des Players werden nicht dauerhaft gespeichert. Die Daten werden für Übertragung und Wiedergabe nur in flüchtigen Puffern gehalten.
Sprachhinweise können weiterhin im verschlüsselten Inhalt einer Assistant-Nachricht liegen. Der aktuelle S2-Pro-Pfad nimmt daraus jedoch keine verbindliche Spracheinstellung entgegen. Diese Hinweise sind keine öffentlichen Profildaten. Ephraim nimmt für das Vorlesen keine Nutzerstimme auf und wertet keine Stimme aus.